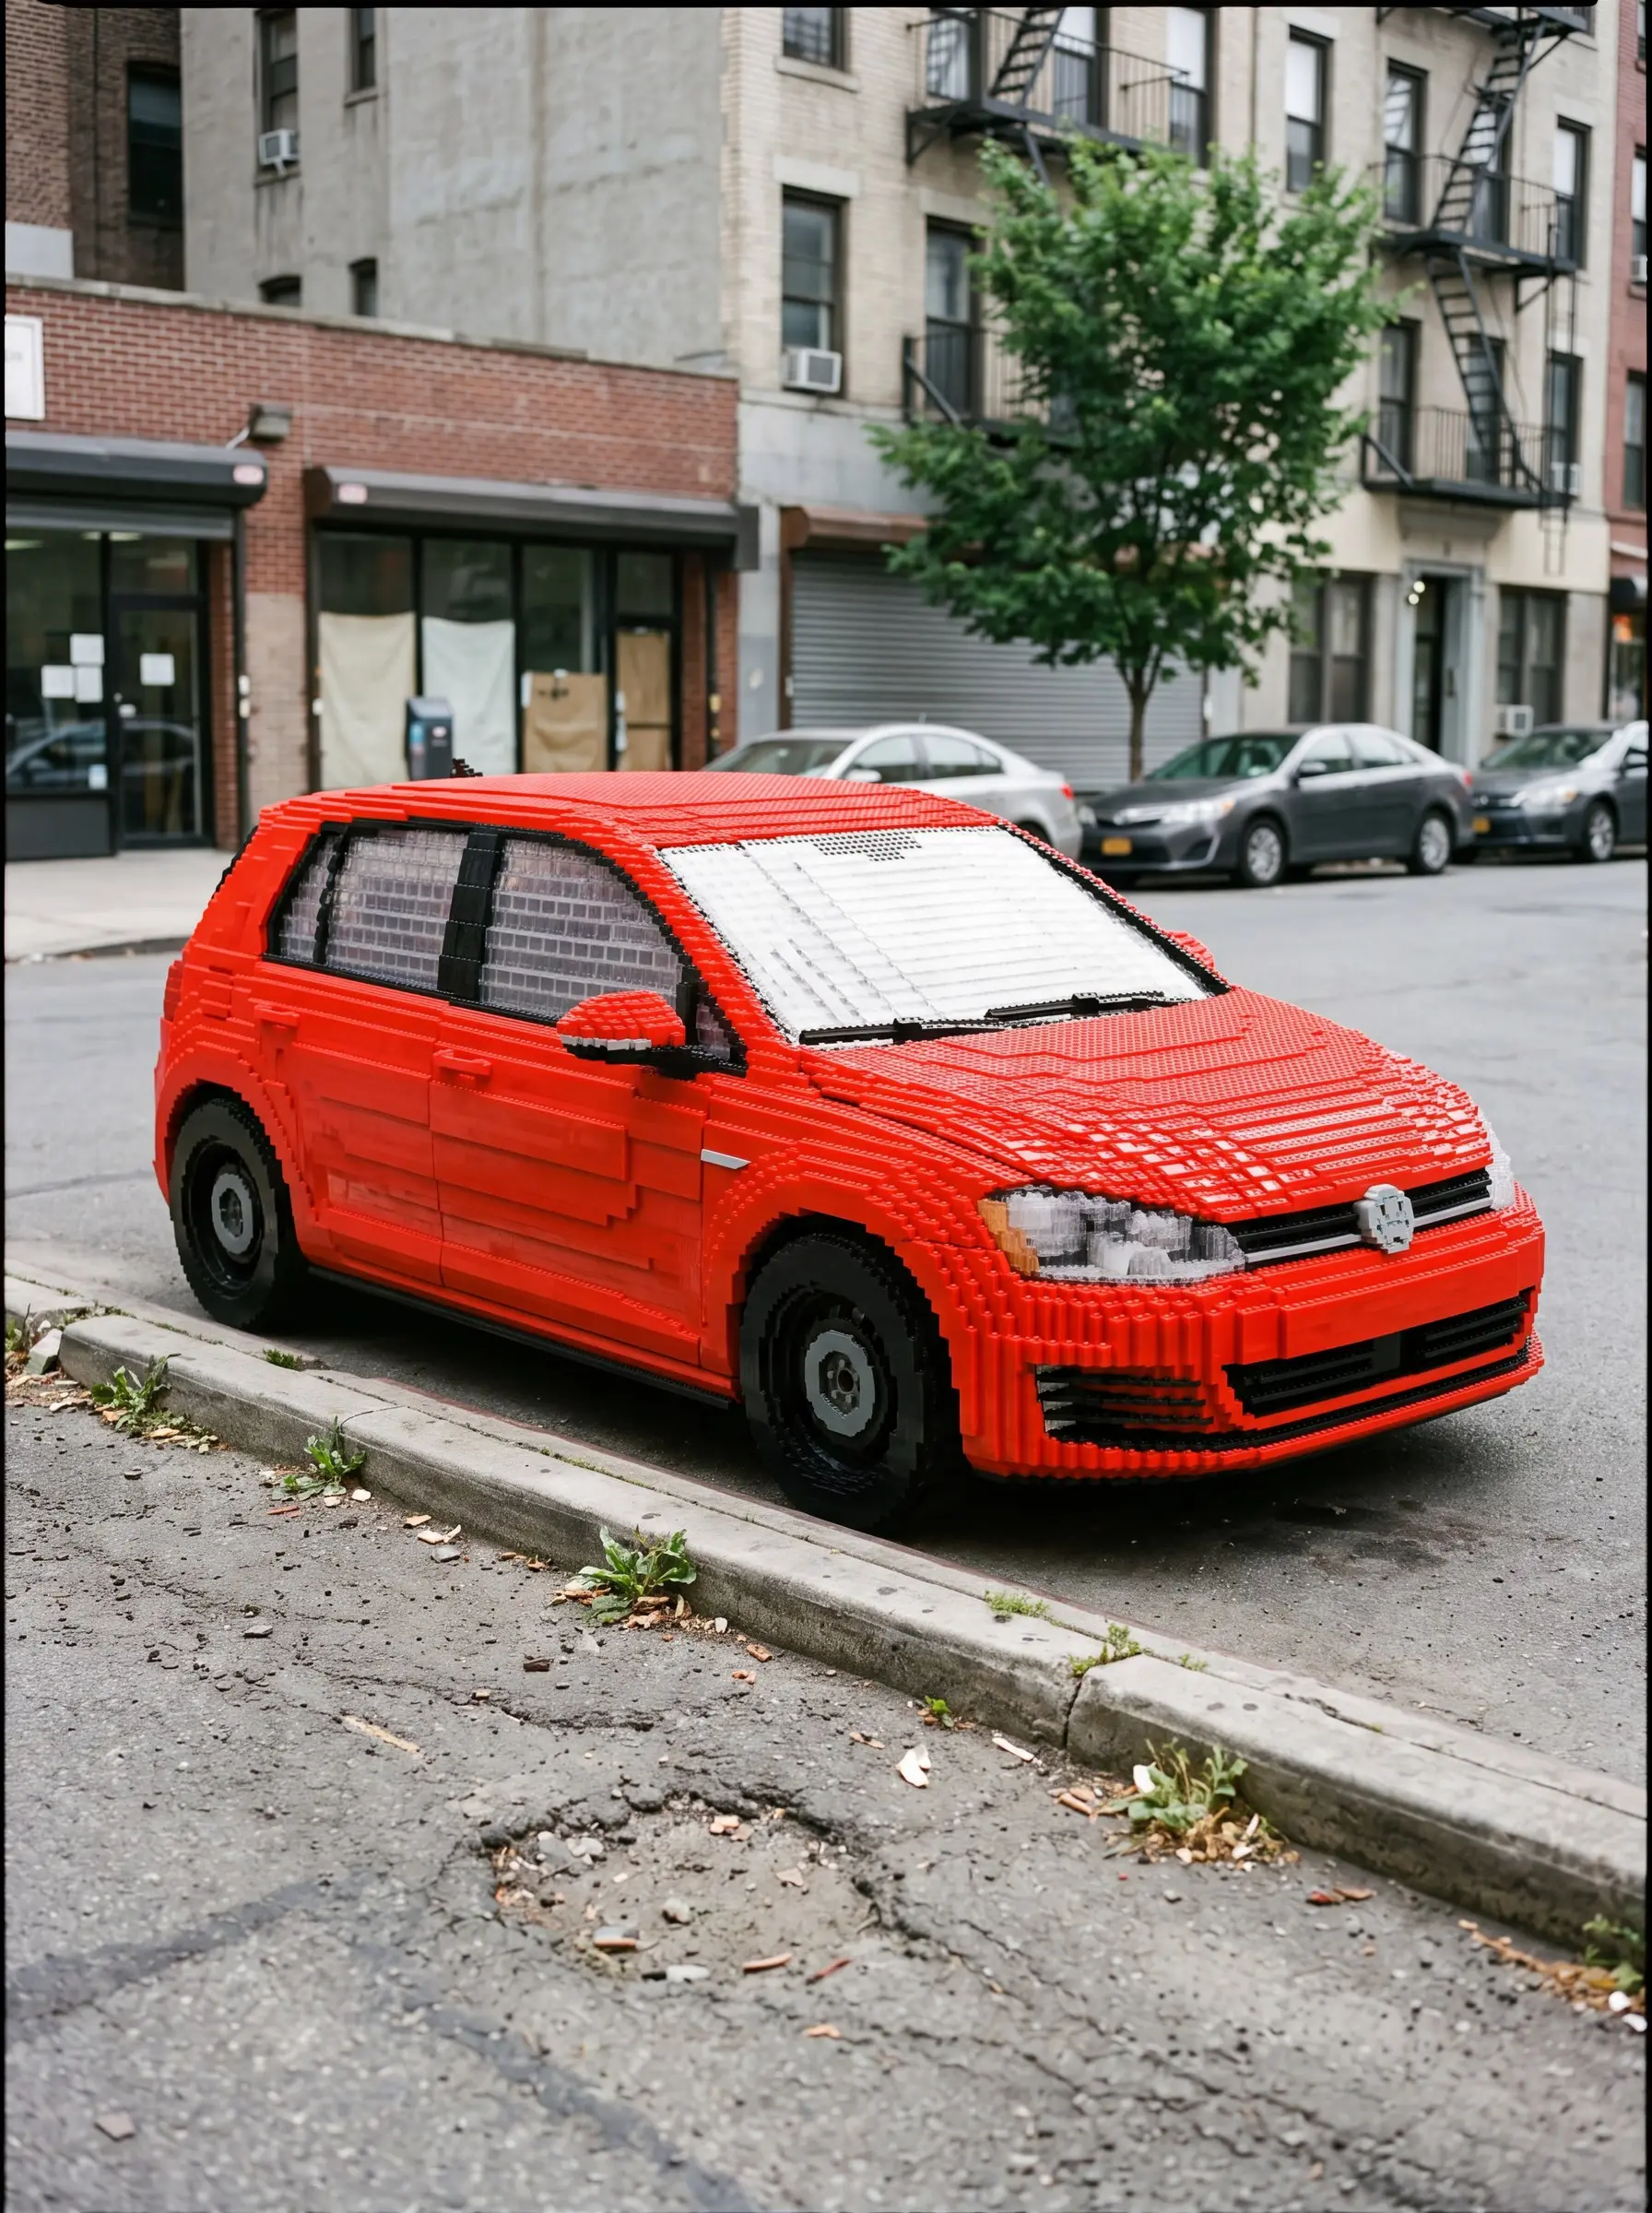
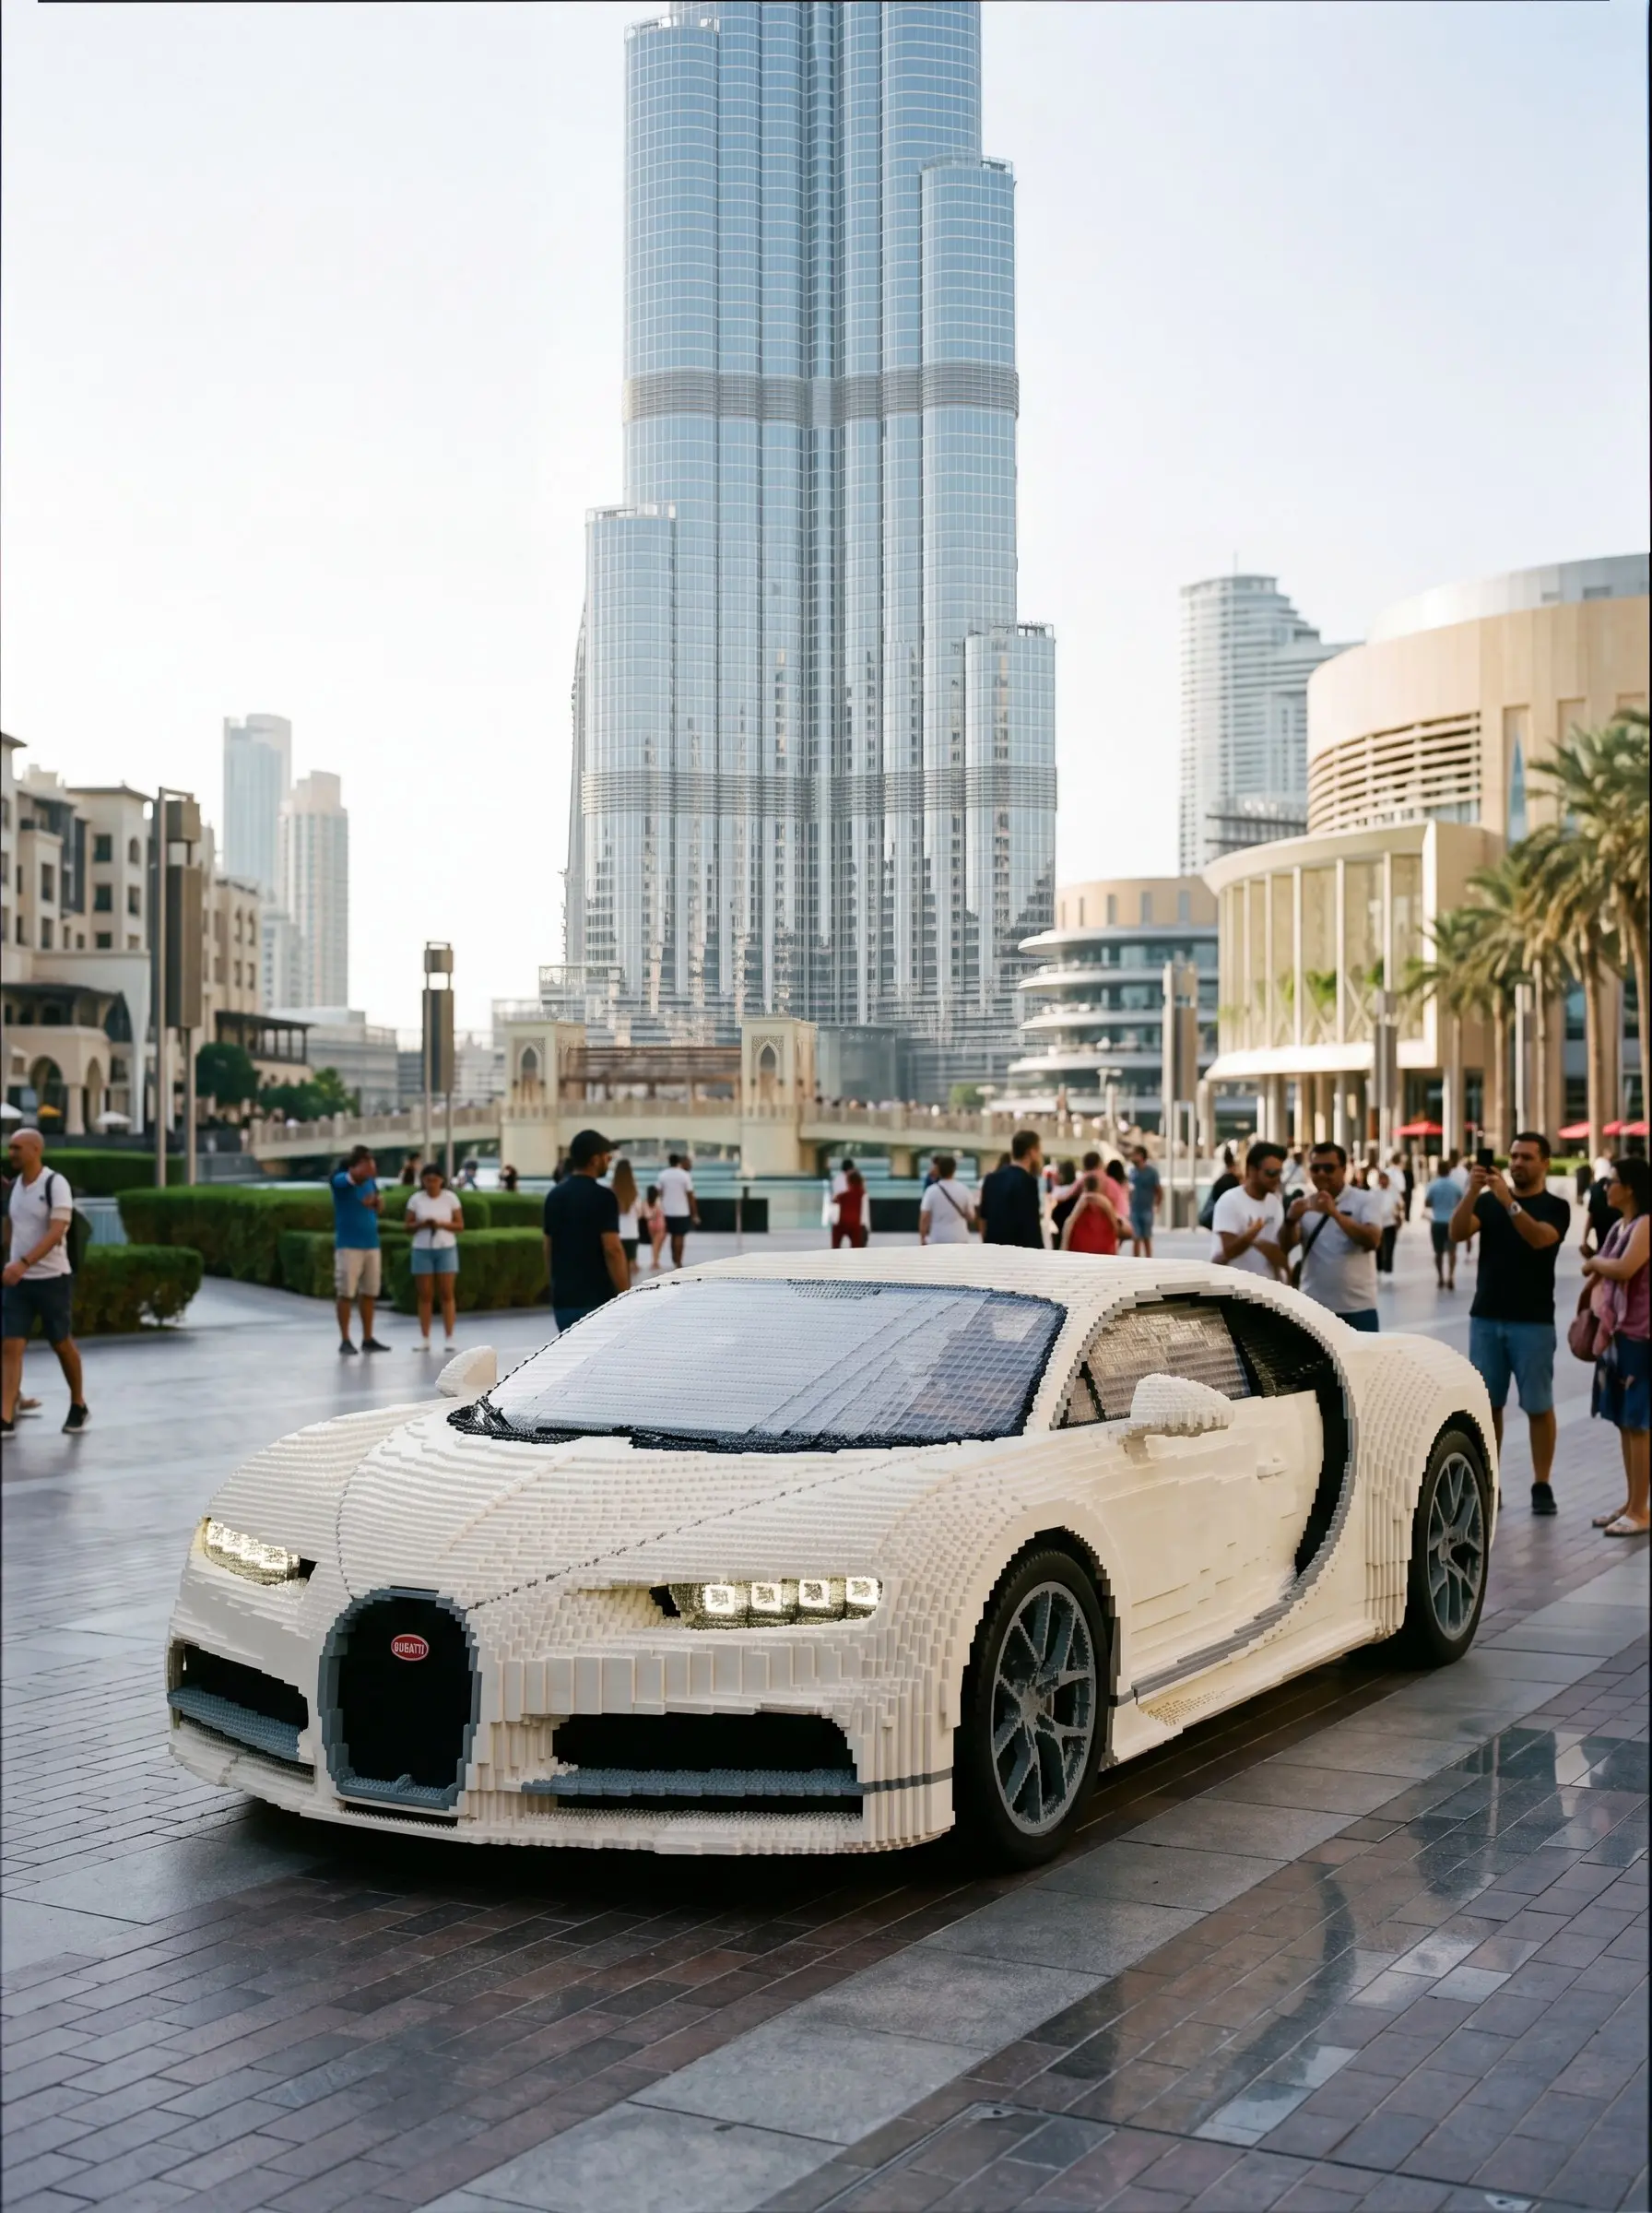



このプロンプトについて
写真の車だけをブロック玩具で作り直し、背景や人物はフォトリアルのまま残します。 結果は、英語で書かれ ChatGPT Image でテストした、3:4 の画像 1 枚です。
最適な入力。 プロンプトは書かれたとおりの形で始め、一度に一つの要素(被写体、背景、ライトなど)だけを変えてください。形容詞を長く並べると、スタイルが鋭くなるどころか、ぼやけがちです。
プラットフォームとモデル。 GPT Image 1.5 を使って ChatGPT Image 向けに書かれています。この構造は他の画像モデルでも機能しますが、レンズ、ライト、比率の表現は少し調整が必要な場合があります。最初の結果が意図と違う場合は、やり直すのではなく、同じチャットで修正を依頼してください。